一篇理清 TypeSafe AI、System One、Jev 与 Skill 的关系,并看懂 Choice、Noul、Score 三种决策原语。
如果一个软件只想知道:
这条用户消息,应该交给账单团队、技术团队,还是客服团队?
我们为什么要调用一个擅长写文章、写代码、做复杂推理的大模型?
今天很多 AI 功能都有类似的问题。
系统明明只需要一个分类、一个真假判断,或者一个风险分数,我们却习惯把任务交给 GPT、Claude 这样的生成式大模型,再要求它:
请只返回 JSON,不要解释,不要输出多余内容。
这就像请来一位很会写报告的专家,最后只让他在表格里勾一个选项。
专家当然能做,但这未必是最合适的分工。
最近受到关注的 Jev,想解决的正是这类问题。
它不负责聊天,不负责写文章,也不负责生成代码。它读取自然语言或结构化状态,然后返回软件可以直接使用的判断与概率。
先把结论放在前面:
Jev 不是一个更小的聊天模型,而是一种让软件基于自然语言做结构化判断的模型。
如果时间有限,只需要先记住三件事:
- Jev 返回的是决策和概率,不是聊天文本。
Choice、Noul、Score是它提供的三种判断原语。- 类型化输出保证结果不会跑出预设结构,但不保证每次判断都正确。
一、软件需要的,很多时候不是一段回答
假设用户给客服发来一句话:
我的信用卡被扣了两次,请帮我退款。
如果把它交给普通大模型,大模型可能会回答:
用户遇到了重复扣款问题,并明确提出退款诉求。建议先核对交易记录,再转交账单团队处理。
这段话很适合给人看。
但业务系统真正需要的,可能只是下面三个结果:
- 这条消息应该进入哪个处理队列?
- 用户有没有明确要求退款?
- 用户当前有多不满?
换成程序语言,它们分别对应:
选哪个?
是不是?
程度如何?
这些问题不能完全写死成关键词规则。
用户可能不会直接说“退款”,而是说“把多扣的钱退回来”;也可能提到“扣款”,却只是询问账单明细。软件需要一定的语义理解能力。
但它们也不需要一篇开放式回答。
这就是 Jev 想站的位置:
确定性规则无法理解自然语言
            ↓
      Jev 做窄范围判断
            ↓
通用大模型处理复杂推理和生成
TypeSafe 对这类能力的概括是:Decisions, not strings。
不是再生成一段字符串,而是直接给软件一个可以参与分支、排序和门禁的决策。
二、先把几个名字理清楚
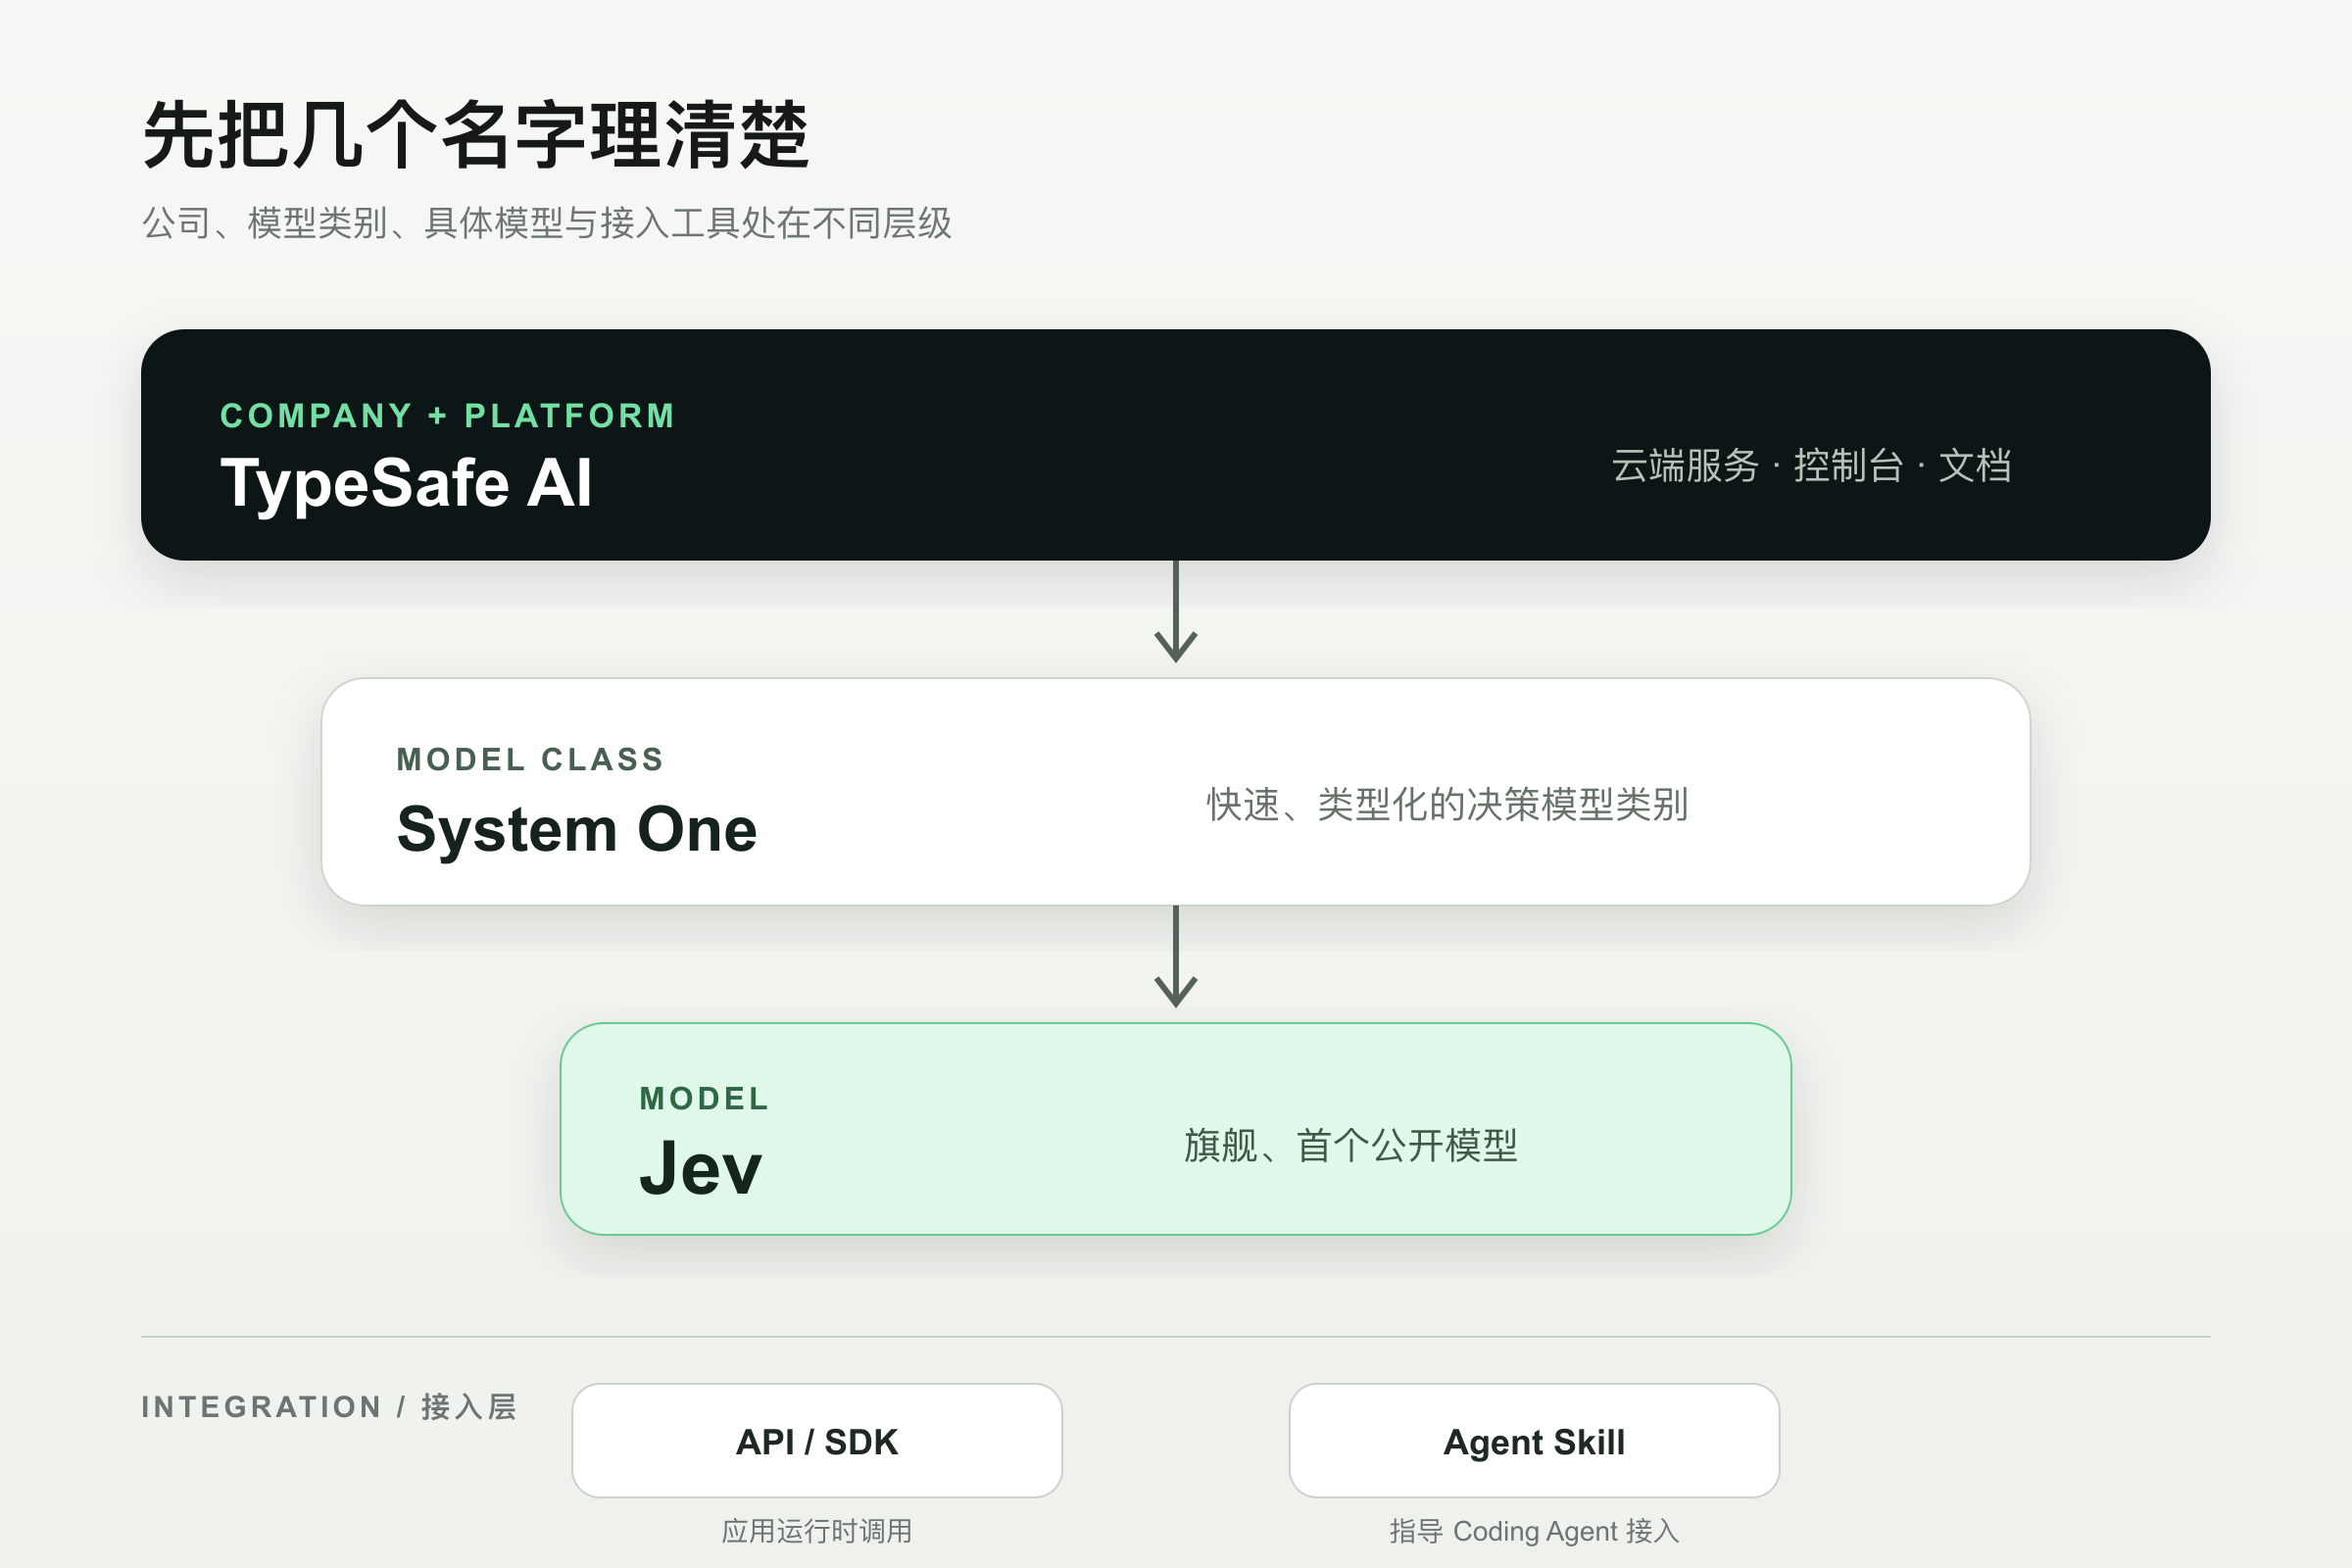
第一次接触 Jev,最容易把 TypeSafe AI、System One、Jev 和 Skill 混在一起。
它们其实处在不同层级。
TypeSafe AI
TypeSafe AI 是公司和平台。
它提供 Jev 的云端服务、API、客户端 SDK、控制台和开发文档。
System One
System One 是 TypeSafe 提出的一类模型。
这个名字借用了《思考,快与慢》中“系统 1”的概念:快速、直觉、聚焦于当下判断。这里更应该把它理解为一种产品定位,而不是说模型真的复刻了人脑。
TypeSafe 对 System One 的定义很明确:模型读取一份 state,返回类型化答案和概率,供软件直接使用。
Jev
Jev 是 TypeSafe 当前的旗舰模型,也是第一个公开提供的 System One 模型。
它不是 TypeSafe AI 的简称,更不是一个聊天产品。
API、SDK 和 Skill
真正让应用在运行时调用 Jev 的,是 HTTP API,或者官方提供的 Python、JavaScript SDK。
TypeSafe Skill 则是给 Claude Code、Codex 等 Coding Agent 使用的一份能力说明。它告诉 Agent:Jev 有哪些原语、接口怎么调用、问题应该怎样拆分。
所以,安装 Skill 不会把 Jev 下载到本地,也不会把 Claude 或 Codex 的底层模型替换掉。
它只是让 Coding Agent 更会帮你编写 Jev 集成代码。
目前 Jev 通过 TypeSafe 的远端 API 提供服务,官方没有公开模型权重。开源的是 TypeSafe Skill,以及 Python、JavaScript 客户端 SDK。
三、同一个问题,Jev 和普通大模型会怎样回答?
还是刚才那条消息:
我的信用卡被扣了两次,请帮我退款。
普通大模型擅长把它变成一段可读的解释:
用户报告了重复扣款,并明确请求退款。
建议转交账单团队,核对交易后处理。
Jev 的使用方式不同。
开发者需要先定义问题和答案空间。例如:处理部门只能从 billing、technical、account 中选择;退款诉求则是一个真假判断。
它返回的结果更像这样:
{
  "department": {
    "choice": "billing",
    "probabilities": {
      "billing": 0.96,
      "technical": 0.02,
      "account": 0.02
    },
    "confidence": 0.94
  },
  "refund_requested": {
    "noul": 0.98
  }
}
以上数字只是为了说明返回形态,并非一次真实评测结果。
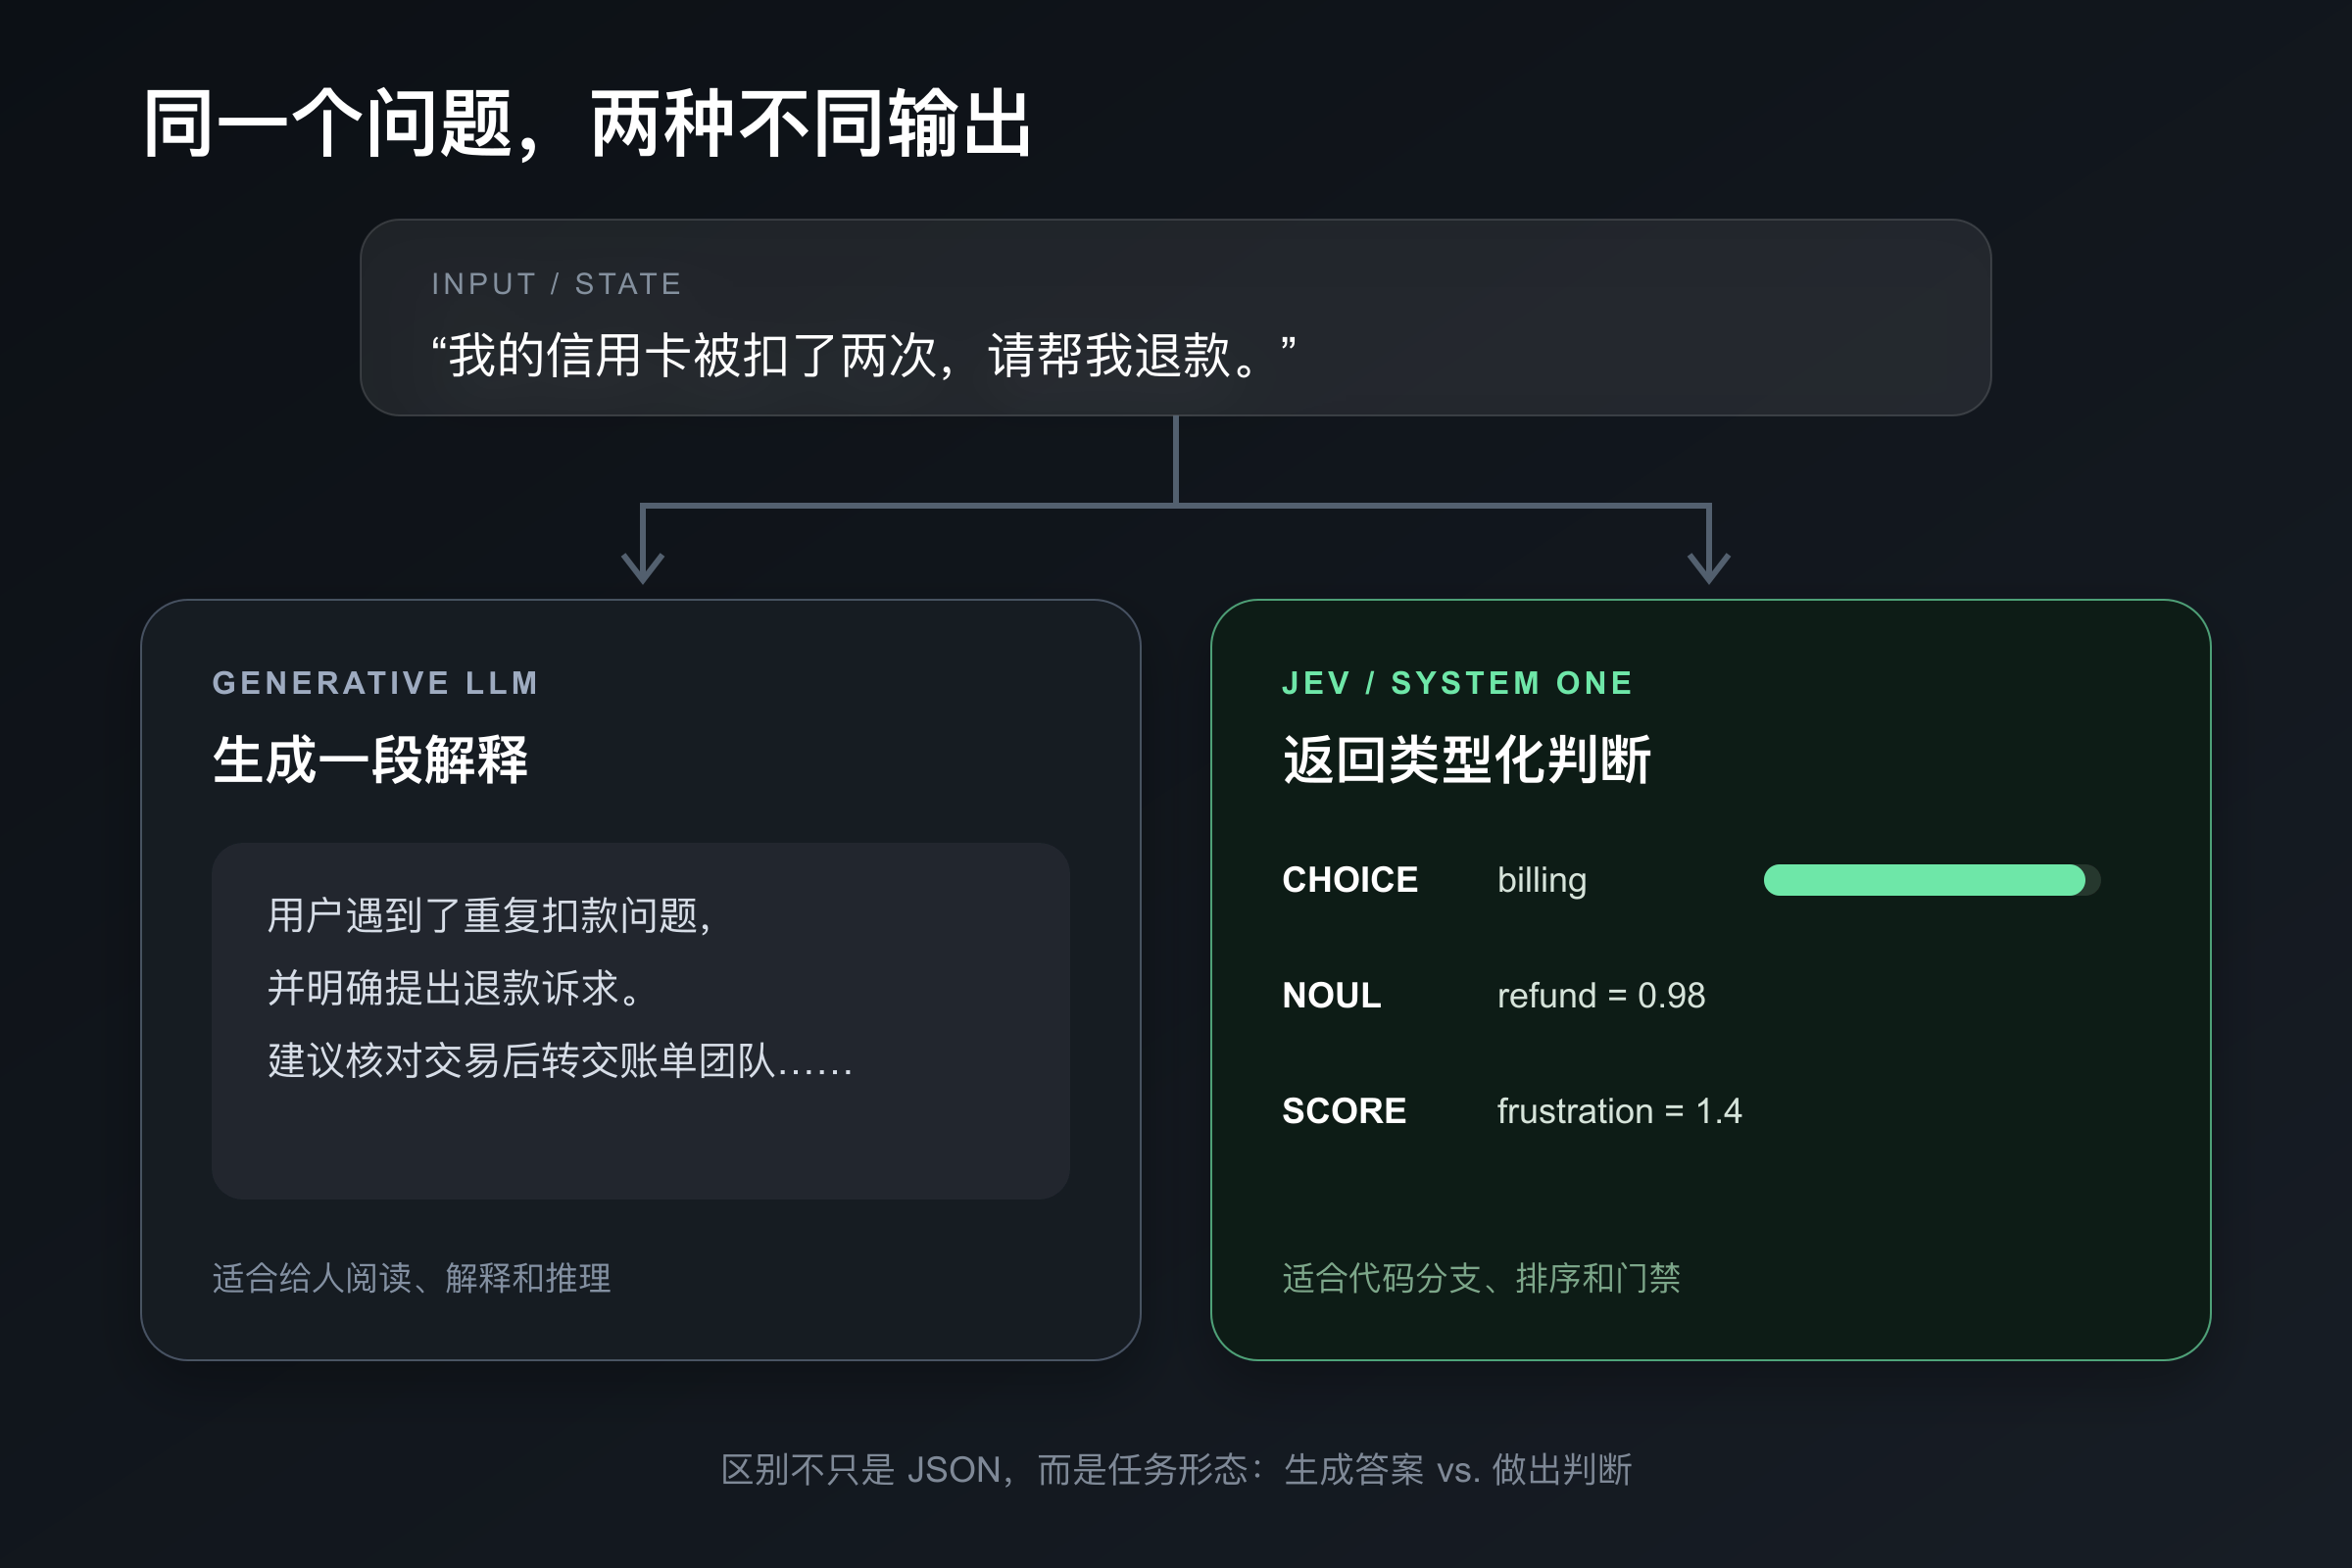
两者的区别,不只是“一个返回文字,一个返回 JSON”。
| 维度 | GPT、Claude 等普通大模型 | Jev |
|---|---|---|
| 主要任务 | 生成、解释、写代码、复杂推理 | 分类、判断、评分 |
| 答案空间 | 通常是开放的 | 由开发者提前限定 |
| 输出形态 | 文本、代码或结构化内容 | 类型化答案与概率 |
| 工作流控制 | 模型可以参与规划下一步 | 代码负责组合判断和执行 |
| 适合位置 | 需要“想清楚、说明白”的环节 | 高频、窄范围的语义判断 |
一句话概括:
普通大模型更擅长回答“为什么、怎么做”,Jev 更擅长回答“选哪个、是不是、程度如何”。
四、Choice、Noul、Score:Jev 的三种决策原语
Jev 的模型接口不是开放式聊天接口。它对外提供的核心问题类型目前有三种。
TypeSafe 把它们称为 Primitives,也就是可以被代码继续组合的基础原语。
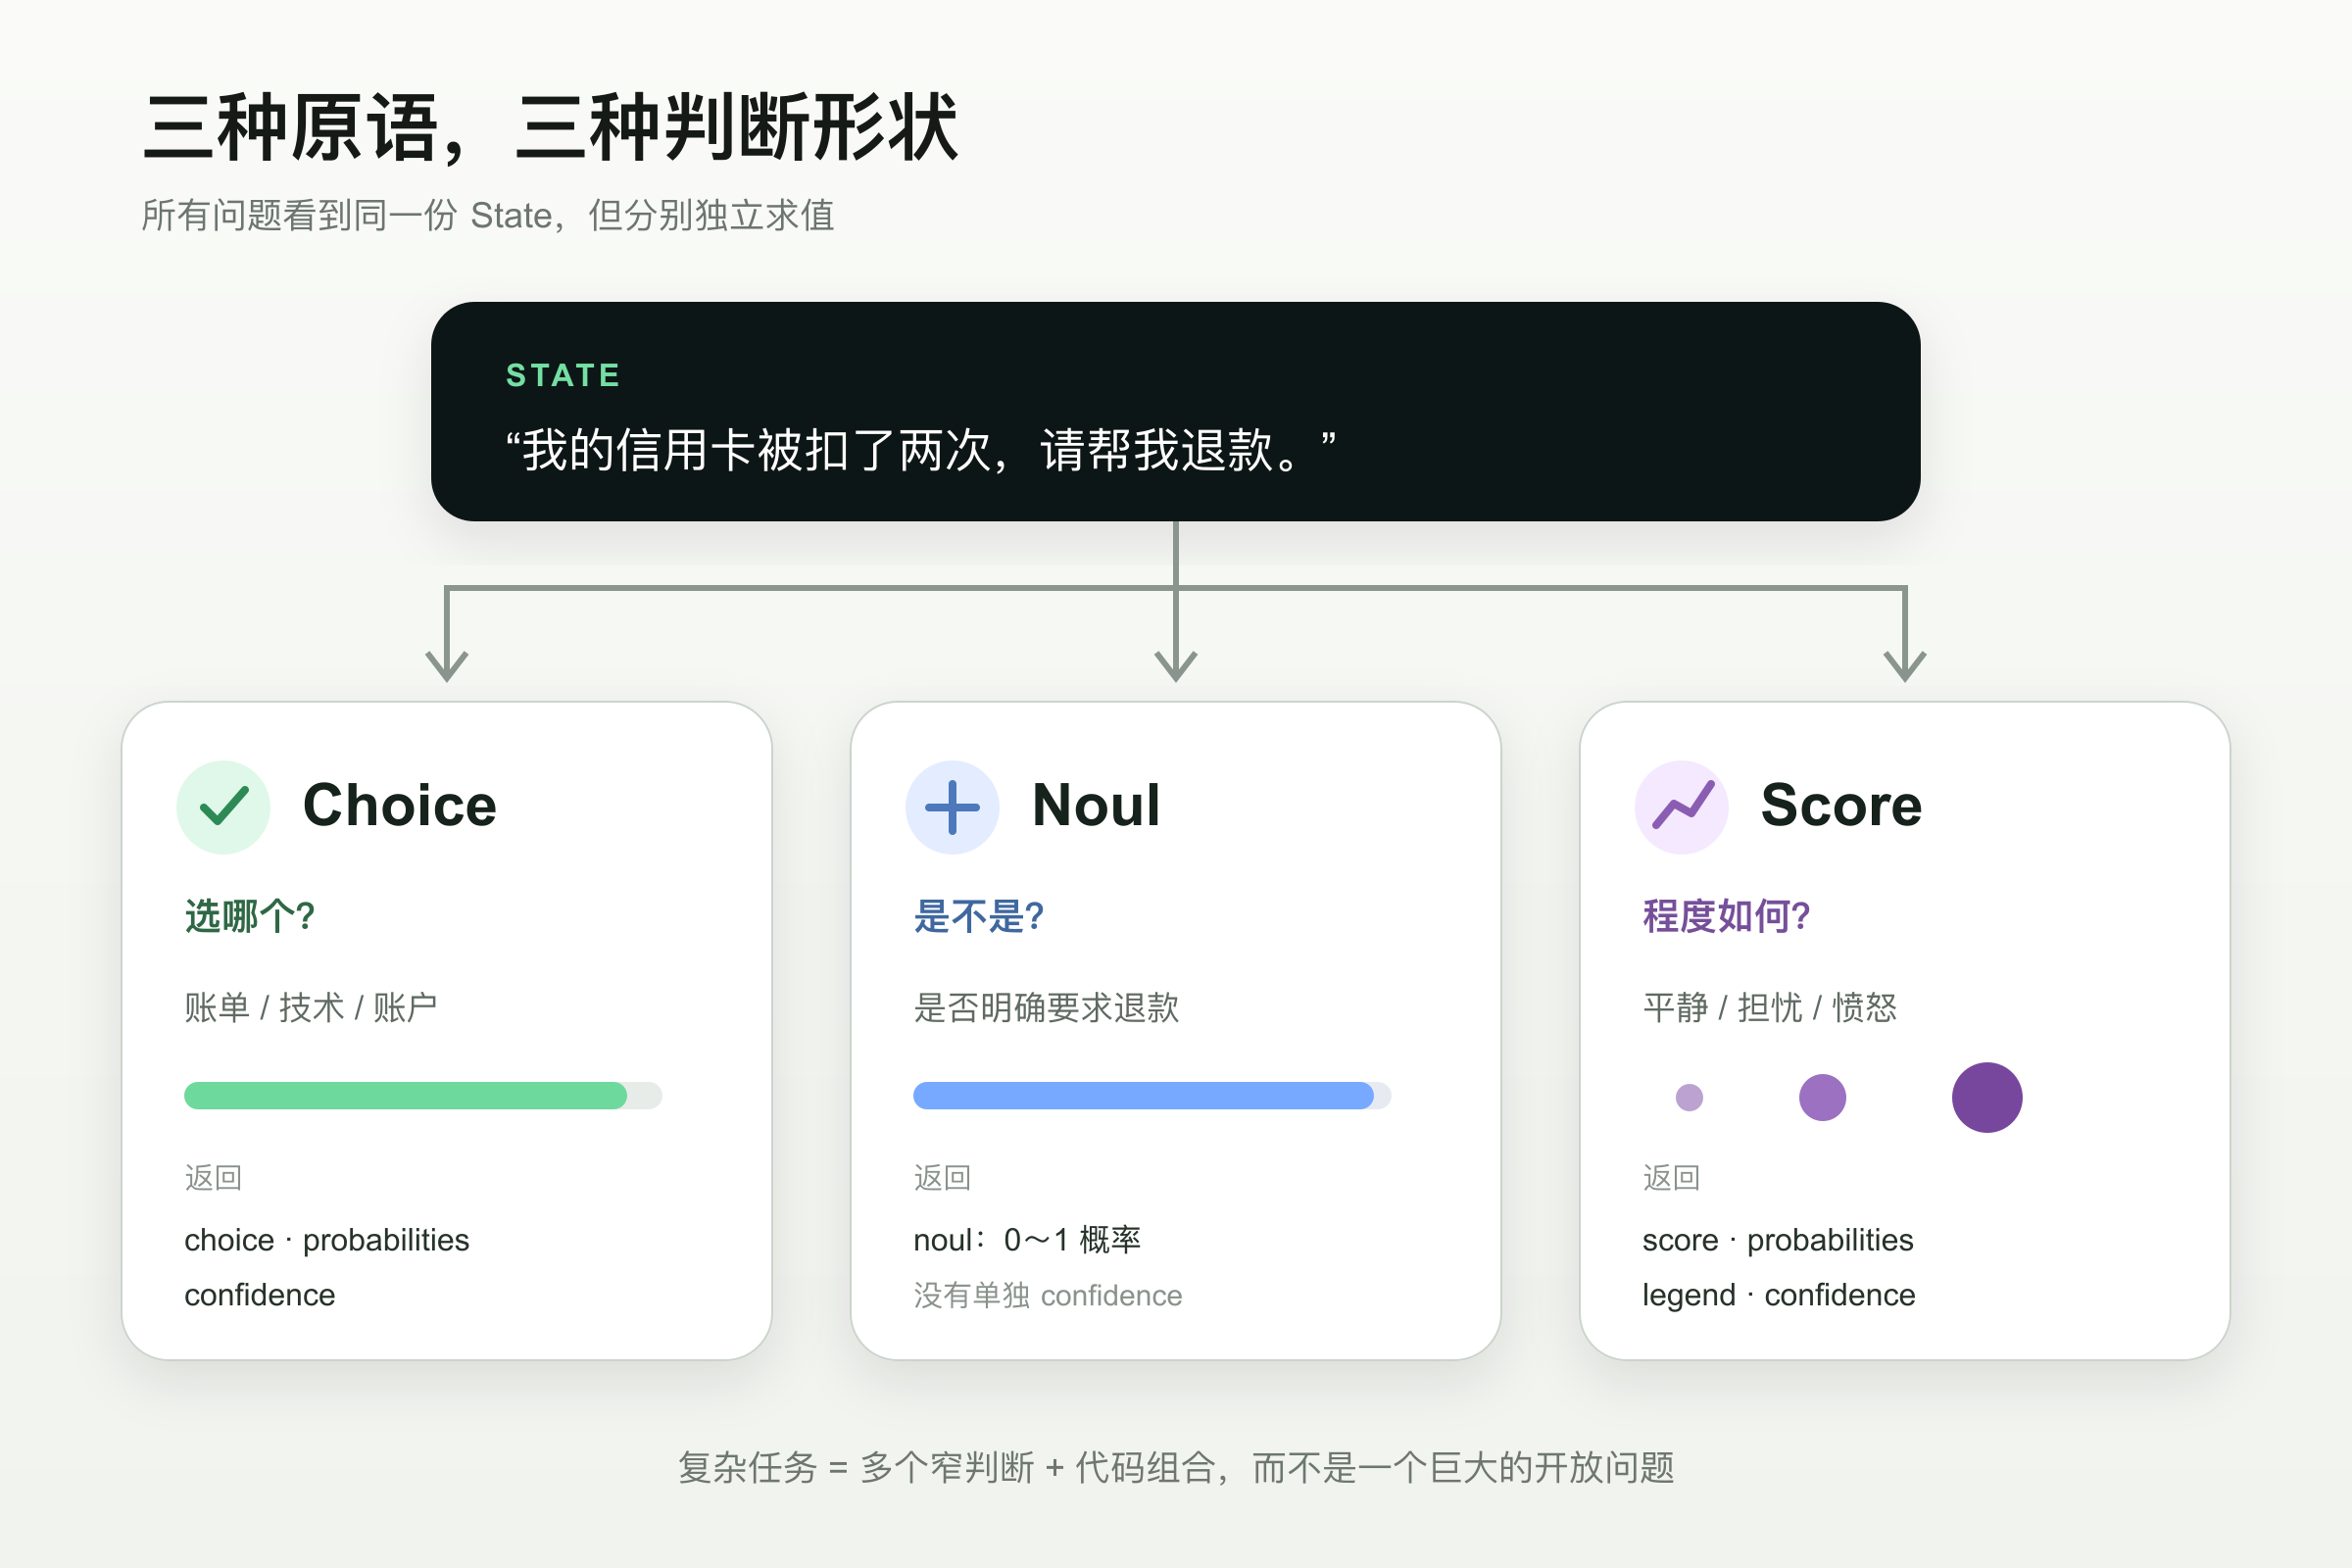
在理解三种问题之前,还要先认识一个词:State。
State 就是 Jev 作判断时能够看到的材料。
它可以只是一条消息:
我的信用卡被扣了两次,请帮我退款。
也可以是一份结构化对象,里面同时包含用户消息、订单记录和退款规则。
可以把它理解成:在请一个人做判断之前,你先摆在他面前的全部证据。
Choice:选哪个?
Choice 用于从一组已知选项中选出一个结果。
例如:
这条消息应该由哪个团队处理?
候选答案由开发者提前定义:
billing:扣费、账单、退款;technical:故障、接口、功能异常;account:登录、密码、账户信息。
Jev 会返回最终选择、每个选项的概率,以及一个 confidence。
Choice 适合意图识别、请求路由、文档分类和候选项选择。
需要注意:如果现实中可能出现未覆盖的情况,选项里应该加入 other 或“以上都不是”。否则,模型仍然只能从你提供的几个答案里硬选一个。
Noul:是不是?
Noul 是 TypeSafe 为二元判断定义的名字。
例如:
用户是否明确要求退款?
它返回一个 0 到 1 之间的数,表示“这个命题为真”的概率。
- 接近 1:更倾向于“是”;
- 接近 0:更倾向于“否”;
- 接近 0.5:两边接近,模型没有明显把握。
Noul 适合判断是否包含敏感信息、是否需要升级处理、某份证据是否支持一个结论。
它没有单独的 confidence 字段。因为二元问题只需要一个“为真概率”,另一个结果的概率自然就是剩余部分。
Score:程度如何?
Score 用于评估一个具有顺序的维度。
例如:
用户表现得有多不满?
开发者可以定义三个等级:
- 平静,只是在陈述事实;
- 担忧或烦躁,但表达克制;
- 非常愤怒,或者表达了强烈流失意愿。
Jev 会返回每个等级的概率分布、一个加权后的 score,以及 confidence。
因此,Score 不只是贴一个“高风险”标签。代码还可以比较分数、排序工单,或者为不同区间设计不同处理方式。
Choice、Noul、Score 看起来简单,但它们覆盖了软件里大量常见判断:
Choice:下一步走哪条路?
Noul:某个条件是否成立?
Score:某个属性处于什么程度?
复杂任务不应该被塞进一个巨大问题里。
更稳妥的方式,是把任务拆成多个彼此独立的小判断,再由代码组合结果。
五、概率、置信度和校准,不是同一个东西
Jev 最容易被误解的地方,是它返回了一堆看起来很精确的数字。
数字并不会自动等于可靠。
概率:模型如何分配可能性
在 Choice 中,probabilities 表示模型如何在候选项之间分配可能性。
例如:
billing    96%
technical   2%
account     2%
这是模型在当前 State 和问题定义下给出的分布。
Confidence:这个分布有多集中
Choice 和 Score 还会返回 confidence。
如果三个选项是 34%、33%、33%,说明没有明显赢家,confidence 会比较低。
如果分布是 96%、2%、2%,结果明显集中在一个选项上,confidence 会比较高。
但 confidence 反映的是概率分布有多集中,不是对现实世界正确性的担保。
如果 State 里缺少关键证据,或者选项定义本身有问题,模型仍然可能非常确定地选错。
校准:长期来看,概率是否诚实
概率校准关注的是一组预测,而不是某一个答案。
简单理解:如果模型在大量相似任务中反复给出 90% 的概率,那么这些判断长期来看是否真的大约有九成正确?
这是一种统计性质。
它不能把当前这一次的 90% 变成“必然正确”。更不能替团队决定:达到多少概率就可以自动退款、删除数据或执行其他高风险操作。
正确做法仍然是:
- 使用自己的业务样本评测;
- 根据错误成本设置不同阈值;
- 中间区域补充信息或交给更强模型;
- 高风险操作保留人工确认和确定性规则。
概率可以帮助代码分流,但不能替业务承担责任。
六、它和大模型的 Structured Output 有什么区别?
看到这里,开发者通常会问:
GPT、Claude 现在也能按照 JSON Schema 返回结果,为什么还需要 Jev?
这是一个合理的问题。
Structured Output 解决的是:大模型生成的结果必须符合指定结构。
它非常有用。普通大模型可以先完成复杂理解和推理,再把结果放进固定 JSON 中。
Jev 的出发点不同。
它从接口上就把任务限定为 Choice、Noul、Score 这样的判断。它不负责顺便写一段解释,不负责生成代码,也不自己规划接下来要调用什么工具。
所以,两者不是简单的替代关系:
需要开放式生成、复杂推理、解释原因
→ 使用 GPT、Claude 等通用大模型

需要高频、封闭、可由代码直接消费的语义判断
→ 考虑 Jev

可以用确定性规则准确解决
→ 直接使用普通代码
真正值得关注的,不是“谁能返回 JSON”,而是我们是否应该继续让同一种模型承担生成、推理、分类、评分、路由和验证等所有职责。
七、Jev 不是什么
理解一个新模型,知道它不能做什么同样重要。
Jev 不是聊天机器人。
你不能让它像 ChatGPT 一样和用户持续对话,也不能让它直接写一篇文章。
Jev 不是 Coding Agent 的替代模型。
它不能直接替换 Claude Code 或 Codex 背后的大模型。Coding Agent 可以帮你写调用 Jev 的代码,但 Jev 本身不负责理解整个开发任务、修改文件和执行命令。
Jev 不是知识库。
它能否判断正确,取决于你放进 State 的信息是否充分、问题是否清晰、候选项是否覆盖现实情况。
Jev 也不是绝对正确的规则引擎。
类型化输出能够保证结果落在预定义结构内,却不能保证它一定选中了现实中的正确答案。
最后,Jev 当前也不是一个可以下载权重、本地部署的开源模型。官方公开的是托管 API,以及采用 MIT License 的 Skill 和客户端 SDK。
八、Jev 真正带来的变化,是重新分配 AI 的工作
传统软件很擅长确定性逻辑:
金额大于 1000 → 进入审核
订单状态为 closed → 不再处理
用户没有权限 → 拒绝操作
但一旦条件变成“这句话是不是在催退款”“这份材料是否支持某个结论”“这个请求更像哪个业务意图”,普通代码就很难写。
通用大模型能理解这些问题,但让它为每个窄判断都走一遍完整的生成流程,未必是最合适的系统设计。
Jev 提供了另一种分工:
生成模型:负责解释、创作和复杂推理
Jev:负责分类、判断和评分
代码:负责规则、权限、流程和执行
人工:负责高风险或低把握情况
它最值得关注的地方,不是比大模型“更聪明”,而是它迫使我们重新问一个问题:
软件里的每一次 AI 调用,真的都需要生成一段文字吗?
很多时候,答案可能只是一次选择、一次真假判断,或者一个可以被代码使用的分数。
这就是 Jev 想解决的问题。
下次看到一个 AI 需求,可以先问三句:
- 我要的是一段新内容,还是一个判断?
- 这个判断能否收敛为“选哪个、是不是、程度如何”?
- 拿到概率后,代码是否知道如何分流,哪些情况必须交给人?
如果第一题的答案是“判断”,后两题也有明确答案,Jev 才开始变得值得讨论。
下一篇,我们会从注册 TypeSafe AI、创建 API Key 开始,在 Playground 中完成第一次真实的 Jev 判断,看看这些概念落到实际产品里究竟是什么样子。
官方资料
- System One:Jev 与普通 LLM 的区别
- State:Jev 会看到什么信息
- Primitives:Choice、Noul 与 Score
- Confidence:概率与置信度如何使用
- Jev with coding agents
- TypeSafe Agent Skill
本文资料核验于 2026 年 9 月 23 日。Jev 仍处在快速迭代阶段,模型能力和产品信息请以官方最新文档为准。